


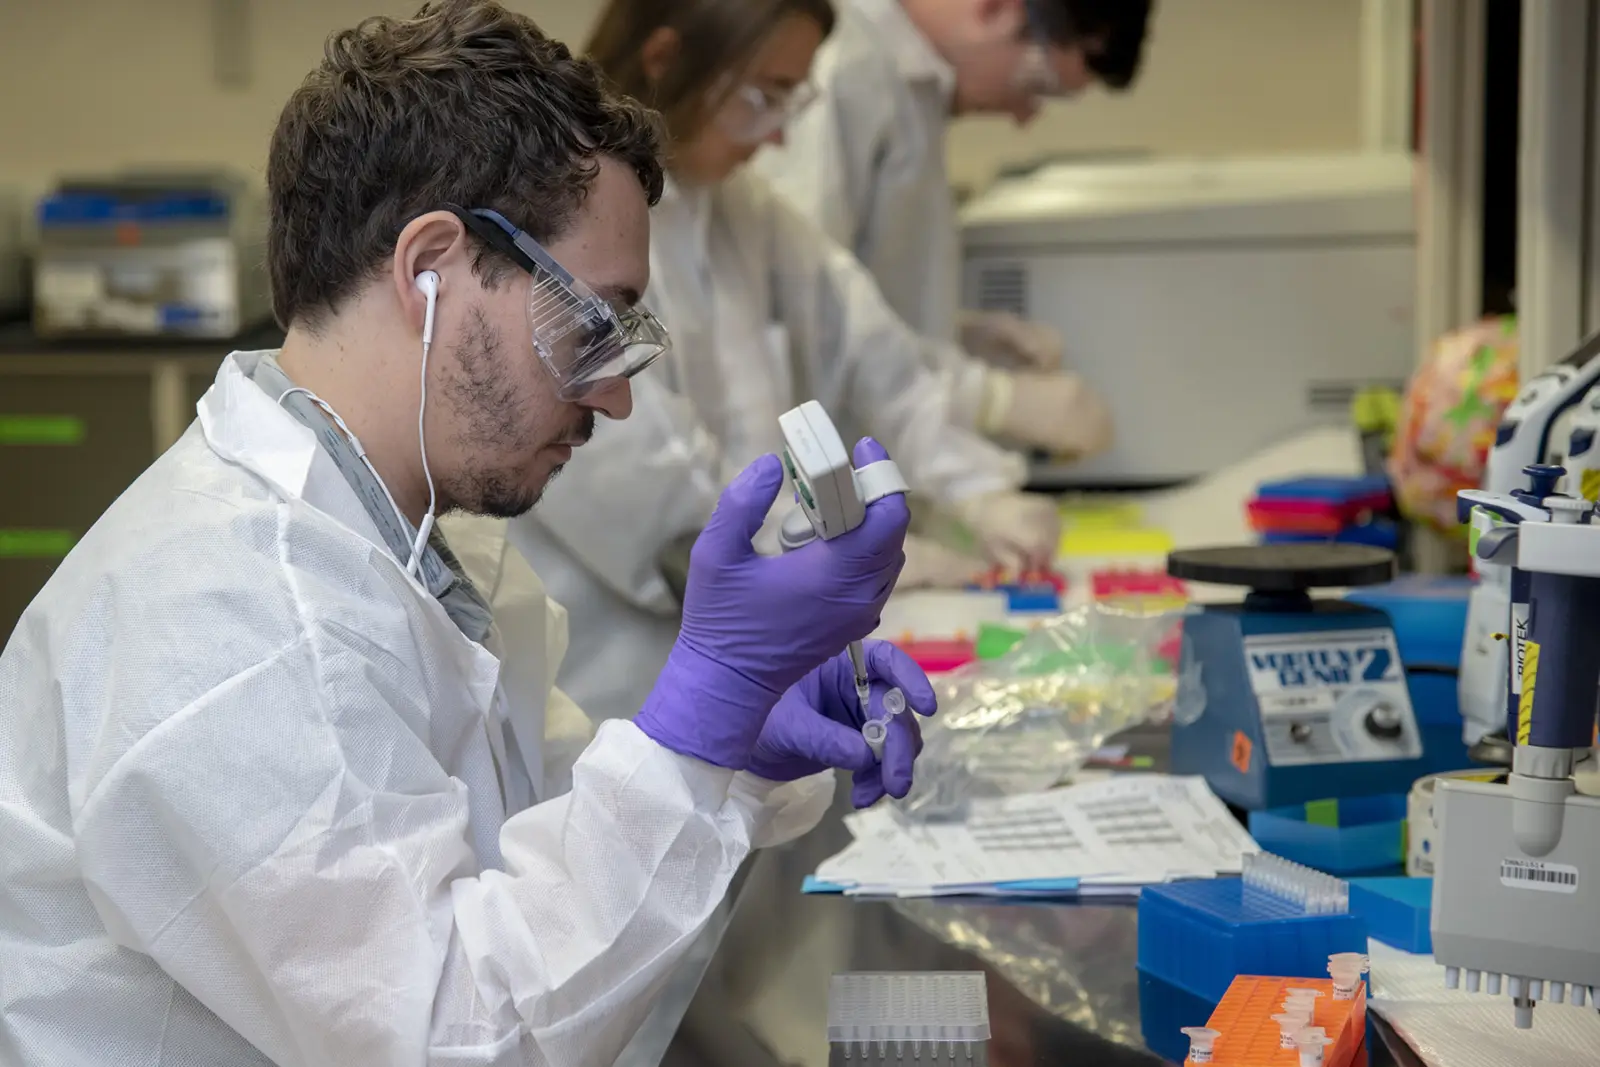
Durante años, secuenciar un genoma completo fue un trabajo lento y caro, porque cada fragmento de ADN requería un experimento propio. Así lo recuerda Pascal Mayer, Premio Princesa de Asturias de Investigación Científica y Técnica, que en una entrevista repasa la evolución de estas tecnologías, sus posibilidades y sus límites técnicos.
El punto de partida que describe es claro. En los años 90 la secuenciación ya estaba automatizada, pero seguía avanzando fragmento a fragmento. Preparar clones, manipular muestras y leer las secuencias una a una hacía que el proceso fuera extremadamente lento y costoso para cualquier genoma completo.
Lo que hace interesante esta entrevista es que no se limita a describir un avance, sino que explica por qué los métodos actuales funcionan como funcionan y qué precauciones exigen. Mayer insiste en una idea que atraviesa todo el diálogo: una tecnología puede ser científicamente correcta y, aun así, fracasar en el terreno comercial. Esa afirmación, que la entrevista deja planteada sin desarrollarla en el ámbito empresarial, sirve de hilo para entender el resto de su argumento.
De una muestra por tubo a millones de moléculas en paralelo
El cambio conceptual que describe Mayer es sencillo de enunciar y profundo en sus consecuencias. Consistió en dejar de procesar una muestra de ADN por tubo para procesar millones de moléculas de ADN en paralelo sobre una superficie. Esa idea dio origen a lo que se denomina secuenciación por colonia, o por conglomerado, de ADN.
En ese esquema, millones de colonias pueden crearse simultáneamente mediante PCR en una superficie. El entrevistado reconoce que él mismo llegó a denominar esa técnica «PCR en fase sólida», un término que, según sus propias palabras recogidas en el texto, empleó de forma incorrecta. La entrevista lo recoge tal como aparece, sin corregirlo a posteriori.
Según explica Mayer, la clave del método está en separar dos pasos que tienen velocidades muy distintas. Por un lado, el paso enzimológico de incorporación de nucleótidos es lento. Por otro, la detección fluorescente con cámaras CCD es rápida. Al desacoplarlos, las colonias pueden analizarse simultáneamente en cuestión de minutos, y después se pueden adquirir muchas imágenes en un tiempo total similar.
Ese diseño explica el salto de escala que el entrevistado identifica como la principal limitación de la etapa anterior. Mientras cada fragmento fuese un experimento individual, la cantidad de información que se podía obtener quedaba muy por detrás de la que el laboratorio necesitaba. Al trabajar sobre millones de moléculas a la vez, el cuello de botella se desplaza hacia otros puntos del proceso, algo que la entrevista aborda en los bloques siguientes.
Del tubo a la superficie
Antes, cada fragmento de ADN se trataba como un experimento individual. Con la secuenciación por colonia, millones de moléculas se procesan en paralelo sobre una superficie, y la detección fluorescente se separa del paso enzimológico, que es el más lento.
Las cifras que ordenan el cambio
La entrevista aporta algunas magnitudes que ayudan a dimensionar la diferencia entre ambos enfoques. Las presentamos tal como las expone el entrevistado, sin derivar otras a partir de ellas.
Varios minutos es la duración del paso enzimológico lento de incorporación de nucleótidos.
Segundos es lo que tarda la adquisición de una imagen con cámaras CCD.
Millones o incluso miles de millones es el número de colonias de ADN que pueden analizarse simultáneamente.
En el terreno de la replicación genómica, Mayer recurre a las tasas de mutación reportadas para explicar cuántos cambios pueden aparecer en cada división celular. Según los valores que cita, el número de mutaciones por replicación se sitúa en unas 10, con un rango que va desde ligeramente menos de 1 hasta algo más de 100. Son cifras que sirven para entender por qué la variación genética existe incluso entre células que parecen idénticas, un asunto que retoma más adelante.
Conviene leer estas cifras como lo que son: ejemplos que ilustran la explicación del entrevistado y no un balance cerrado de la técnica. La entrevista no ofrece otros indicadores de rendimiento, costes actuales ni comparativas entre plataformas comerciales.
Una polimerasa para cada tarea
Uno de los puntos más técnicos de la conversación es la elección de la enzima. Mayer señala que no existe una polimerasa óptima universal. La polimerasa debe seleccionarse u optimizarse por bioingeniería para cada aplicación, y en su explicación recuerda que así se hizo en Solexa, donde la enzima se adaptó a un uso concreto.
«No existe un óptimo universal. Una polimerasa debe ser seleccionada u optimizada por bioingeniería (como se hizo en Solexa) para la aplicación.»
Pascal Mayer, Premio Princesa de Asturias de Investigación Científica y Técnica
La razón es que las propiedades deseables no siempre se alinean. El entrevistado enumera la fidelidad, la velocidad, la procesividad, la tolerancia a nucleótidos modificados y la compatibilidad con el entorno de reacción. Según explica, estas propiedades pueden influir en direcciones distintas, de modo que mejorar una puede empeorar otra.
De ahí se deriva su visión de conjunto. Para secuenciar bien importa optimizar el sistema completo: polimerasa, química de nucleótidos, amplificación, imagen y análisis de señales. Ninguna pieza, por sí sola, garantiza el resultado. Esa es la idea que sostiene su afirmación de que la secuenciación no es simplemente «leer ADN».
Dónde puede equivocarse la secuenciación
Mayer describe la secuenciación como una cadena de mediciones físicas, químicas y computacionales. Esa cadena tiene varios focos de error, y su peso relativo cambia según la aplicación.
«La secuenciación no es simplemente «leer ADN». Es una cadena de mediciones físicas, químicas y computacionales, y la fiabilidad del resultado final depende de toda la cadena.»
Pascal Mayer, Premio Princesa de Asturias de Investigación Científica y Técnica
Según el entrevistado, los tres focos principales son la preparación de la biblioteca, la amplificación y la plataforma de secuenciación. En la primera, la preparación puede introducir sesgo de muestreo. En la amplificación, puede crear errores o distorsionar la representación de las moléculas. Y la química de secuenciación y el procesamiento de señales tienen, a su vez, modos de error propios.
La consecuencia práctica es que el error no se elimina con una sola mejora. Mayer subraya que su importancia relativa depende de lo que se quiera averiguar, de modo que una misma técnica puede ser muy fiable para una pregunta y frágil para otra.
- Preparación de la biblioteca: puede introducir sesgo de muestreo.
- Amplificación: puede crear errores o distorsionar la representación.
- Plataforma de secuenciación: la química y el procesamiento de señales tienen sus propios modos de error.
Cuando el error baja, manda la biología
Quizá la parte más reveladora de la entrevista es la que plantea qué ocurre cuando los errores técnicos se reducen a niveles muy bajos. Según Mayer, en ese punto la variabilidad procede cada vez más de la propia biología que del instrumento. Es decir, lo que se ve ya no es ruido del laboratorio, sino diferencias reales entre células.
El entrevistado recuerda que incluso las células derivadas de una sola célula por división no son genéticamente idénticas, porque las mutaciones surgen durante la replicación del ADN. Los organismos multicelulares y los microbiomas son, en su descripción, mosaicos de células con genomas ligeramente distintos. A ello se suman los elementos genéticos móviles y las integraciones virales, que pueden añadir variación a lo largo de la vida.
«¿de qué célula de qué individuo en qué momento y en qué entorno?»
Pascal Mayer, Premio Princesa de Asturias de Investigación Científica y Técnica
Con esa pregunta, Mayer resume el desafío de interpretar una secuencia. Para responderla, explica, hay que distinguir la información biológica genuina de los artefactos. Y en ese esfuerzo tiene un papel central la replicación.
Según sus palabras, la información biológica genuina debe observarse repetidamente e independientemente, mientras que muchos artefactos surgen solo una vez. Esa frase, citada literalmente, es la base de su argumento sobre el diseño de los experimentos.
«La información biológica genuina debe observarse repetidamente e independientemente, mientras que muchos artefactos surgen solo una vez.»
Pascal Mayer, Premio Princesa de Asturias de Investigación Científica y Técnica
Para detectar variantes de muy baja frecuencia, los enfoques modernos identifican las moléculas originales de ADN de forma individual, por ejemplo con identificadores moleculares, y comprueban si la misma variante aparece de forma independiente en varias moléculas. Cuando la muestra contiene muy poco ADN, el diseño experimental gana importancia. En ese caso, el entrevistado menciona la replicación y la redundancia, con códigos de barras moleculares, amplificación independiente, profundidad de secuenciación muy alta, comparación con controles y modelado estadístico del error de fondo. Algunos métodos de amplificación lineal, que no propagan errores, también pueden ayudar.
Mosaicismo: cuando la muestra no cuenta toda la historia
Las implicaciones para el diagnóstico son directas, y la entrevista las expone con cautela. El mosaicismo puede hacer que una enfermedad derivada de una mutación surgida durante la embriogénesis permanezca indetectable en pruebas basadas en sangre o en muestras bucales. Eso sería un falso negativo. A la inversa, algunas variantes pueden aparecer en la muestra sin estar presentes en el órgano afectado, lo que sería un falso positivo.
La lección que extrae Mayer es que en el diagnóstico la redundancia y la estadística pesan tanto como la química. Detectar una variante rara exige comprobar que aparece de forma reproducible y no solo una vez, y que el ruido de fondo se ha modelado con rigor. Sin ese control, la misma técnica puede ofrecer lecturas engañosas.
Claves para leer un resultado de ADN
- Una variante genuina debe observarse de forma repetida e independiente.
- Una muestra con muy poco ADN exige más redundancia y controles.
- El mosaicismo puede producir falsos negativos y falsos positivos.
- La fiabilidad depende de toda la cadena, no de una sola etapa.
Lectura corta, lectura larga y lo que queda abierto
Mayer distingue dos grandes familias de tecnologías. Las de lectura corta siguen siendo muy potentes para la secuenciación a gran escala y de alto rendimiento. Según menciona, se aplican en genómica ecológica, microbiomática, genética de poblaciones y genómica del cáncer.
Las lecturas largas, en cambio, son especialmente útiles para reconstruir estructuras genómicas de largo alcance, regiones repetitivas, reestructuraciones estructurales y haplotipos. El entrevistado considera que ambas son muy complementarias, y que el campo combina cada vez más plataformas en lugar de esperar que una sola resuelva todas las cuestiones biológicas.
En varias de sus respuestas, Mayer advierte que no es especialista en algunos de los temas que se tocan. Así ocurre con el ADN antiguo: según explica, el ADN auténtico presenta firmas moleculares de edad y degradación, como la fragmentación y patrones reproducibles de modificación de bases cerca de los extremos de los fragmentos, que ayudan a distinguirlo de la contaminación moderna. Él mismo indica que ese no es su campo, por lo que sus comentarios se limitan a lo general.
El texto disponible termina con una pregunta sobre la amplificación isotérmica como alternativa a la PCR. La respuesta no aparece en el material recogido, así que no es posible reflejar la postura del entrevistado sobre ese punto.
Tampoco constan próximos pasos, plazos o anuncios vinculados a la entrevista. Lo que queda, por tanto, es el planteamiento de fondo: que la fiabilidad de la secuenciación depende de toda la cadena y que, cuanto más bajo es el error técnico, más visible se vuelve la biología real de cada célula.
Nuestra opinión GUAY
Lo que aporta esta entrevista es una manera ordenada de entender por qué secuenciar el ADN exige algo más que una máquina potente. Mayer recorre el paso de la muestra individual a la lectura masiva en paralelo, explica por qué la polimerasa debe ajustarse a cada aplicación y sitúa los errores en cada etapa de la cadena. Para el lector no especialista, la idea más útil es que una secuencia es un resultado que hay que interpretar con diseño experimental, repetición y estadística, y no un dato bruto.
Por la redacción de GUAY.news.
Deja una respuesta